Что именно болит у compliance-агента
Перед онбордингом банк обязан выяснить, кто владеет компанией, и прогнать её со всеми связанными лицами по судам, мошенничеству и негативным новостям. У Bretton около 70% каждой такой работы держится на открытом вебе.
Размер ошибки измеряется в деньгах и лицензиях.
Агенты Bretton работают внутри организаций под надзором OCC, FDIC и ФРС, среди клиентов - MVB Bank, Coastal Community Bank и Mercury. В некоторых процессах время комплаенс-ревью там сократилось на 87%. Первые версии ходили во встроенный веб-поиск фронтир-моделей: он находит удачный ответ и молчит о том, что пропущено. Для аудируемого дела этого мало.
If our agent misses a lawsuit or confuses two people with the same name, the bank makes the wrong call, and a finding without a source can't go in the case file at all.
Прогоните схему на своих запросах: поиск и чтение страниц по одному ключу.
Начать бесплатноКак Bretton прошёл три ступени архитектуры
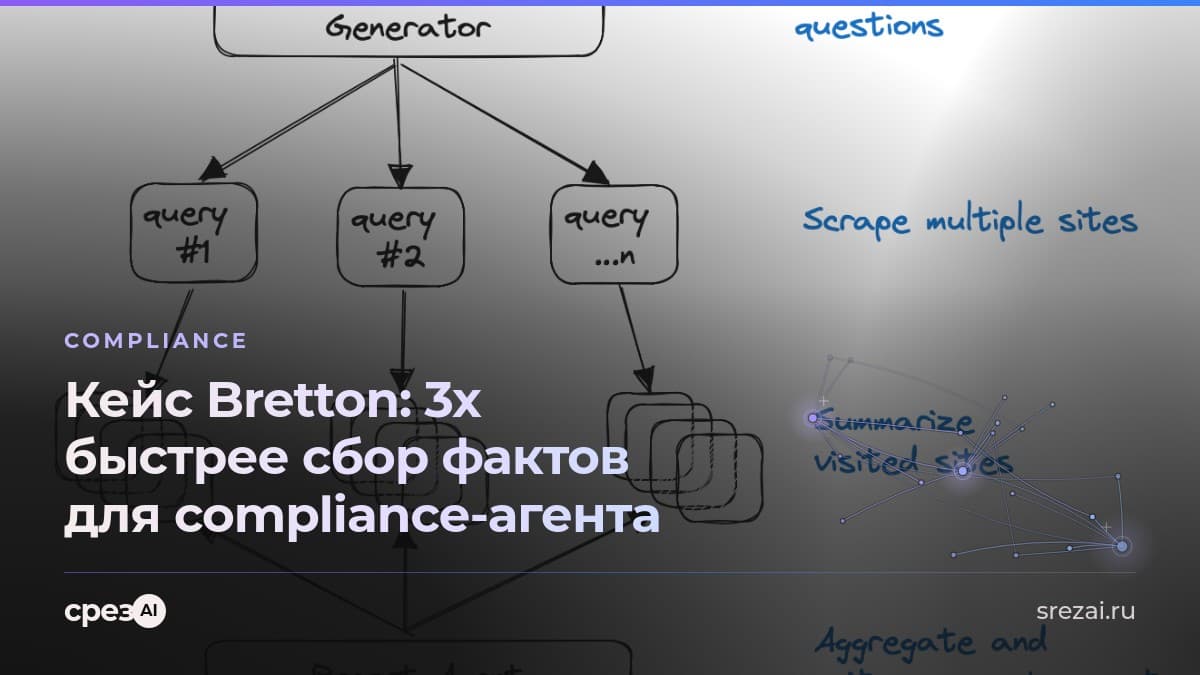
Схема из кейса Bretton читается как чек-лист для любого агента, который копает факты. Три ступени, и на каждой менялись качество и задержка.
| Ступень | Что было | Что стало | Цифры |
|---|---|---|---|
| 1. Поиск и извлечение как инструменты | Встроенный веб-поиск модели | Search API + Extract API внутри цикла агента | По мере роста глубины число Extract-вызовов выросло, появилась задержка |
| 2. Отдельный скилл на задачу | Ручная цепочка вызовов | Task API на каждый research skill | Около 26 параллельных скиллов на дело; отдельные вызовы до 7 минут |
| 3. Вызов внутри живого процесса | Task API для всего | Responses API на каждого исследователя | 7-8 вызовов на расследование, 1-2 минуты каждый, 30-40% задержки Task |
Третья ступень держится на том, что каждый "исследователь" - узкий агент со своим набором полей. Сам API здесь вторичен. Задержка упала до 30-40% от Task при том же качестве, а миграцией руководил Rahul Mohankumar. Если собирать такую цепочку самому, дольше всего возиться с описанием полей: широко сформулированный скилл начинает тянуть сайты целиком, и время растёт. Схема не сработает, если в деле всего пара простых вопросов - 7-8 вызовов вместо одного только добавят ожидание.
Почему одного веб-поиска не хватает для compliance-дела?
Он возвращает удачный ответ и молчит о том, что осталось за кадром. В дело годится находка со ссылкой на источник: без ссылки её просто некуда положить в файл, а проверяющий не увидит, откуда взялся факт.
Чем Responses API отличается от Task API?
Responses API запускается на каждого узкого исследователя, Task API - на весь research skill целиком. Отсюда и разница в задержке.
Сколько вызовов уходит на одно дело?
7-8, каждый по 1-2 минуты.
Схема заработает на российских реестрах?
Логика переносится без изменений: узкие вопросы, чтение страниц, источник рядом с каждым фактом. На российских данных такой конвейер собирается через срезAI, меняется только набор реестров.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.