Зачем агенту отдельный поиск
Большинство задач ИИ-агента начинаются в условиях неопределенности, когда точный адрес страницы еще неизвестен. Если сразу открывать сессию в Browserbase, система потратит ресурсы на отрисовку рекламы и тяжелых скриптов. Модели эти данные не нужны.
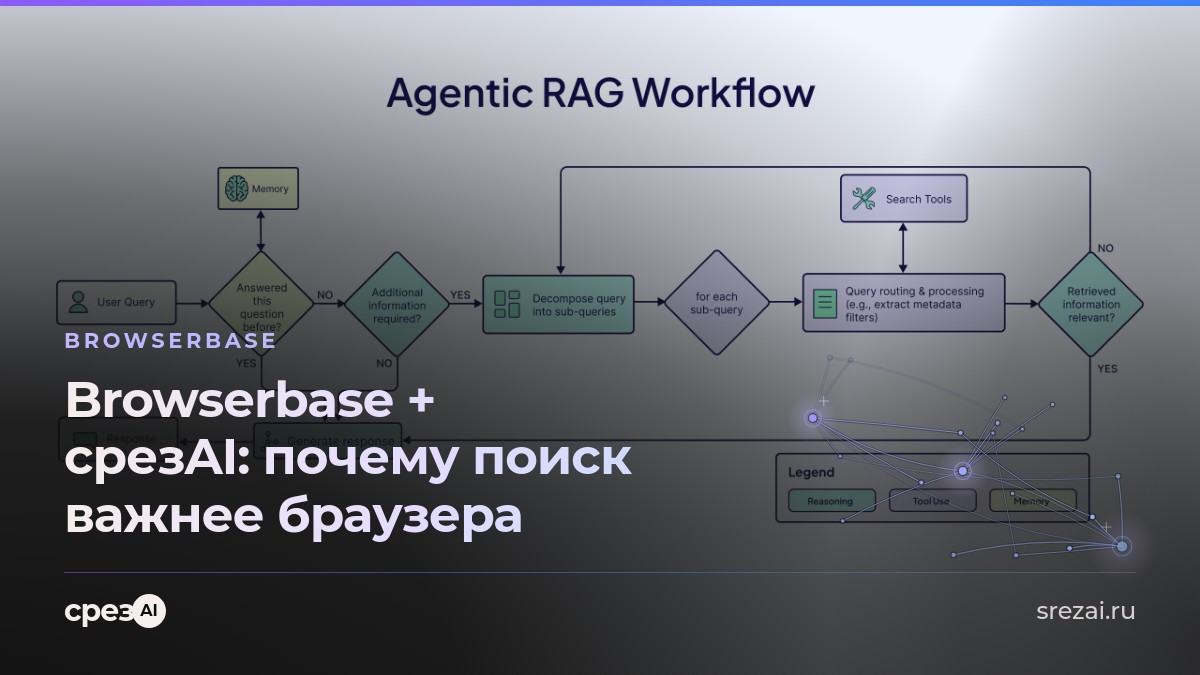
Концепция, которую продвигает Parallel, разделяет процесс на три уровня. Сначала поисковое API находит точки входа. Затем инструмент загрузки текста вытягивает полезную нагрузку. Только если данные скрыты за авторизацией или требуют сложного клика, в дело вступает браузер. срезAI здесь работает как фильтр. Когда я настраивал эту связку в первый раз, то понял: агент без предварительного поиска ведет себя как турист без карты, который заходит в каждое здание города, чтобы купить хлеб.
Как срезAI экономит ваши деньги
Каждая сессия в headless-браузере - это расходы на запуск окружения и время ожидания. срезAI работает как быстрый API-слой с задержкой p50 всего 976 мс. Через наш сервис агент получает очищенный Markdown без лишнего кода.
- Снижение числа сессий: агент открывает Browserbase только с проверенным URL.
- Чистые токены: вместо мегабайтов HTML модель читает структурированный текст.
- Локальная релевантность: срезAI точнее находит данные в сегменте RU.
Попробуйте интеграцию срезAI с вашим агентом уже сегодня - 100 ₽ на баланс при регистрации.
Начать бесплатноПример интеграции в коде
Вместо прямой передачи запроса в браузер, используйте срезAI для получения точных ссылок. Вот пример вызова через наш поисковый API:
import os
import requests def get_search_results(query): # Используем срезAI для первичной разведки url = "https://srezai.ru/api/v1/search" headers = {"Authorization": f"Bearer {os.environ['SREZAI_API_KEY']}"} payload = {"query": query, "num": 3} response = requests.post(url, json=payload, headers=headers) return response.json()["results"] # Если в результатах нет нужных данных, переходим к Browserbase
results = get_search_results("как настроить рендер в браузере для SPA")
for res in results: print(f"Найдено: {res['link']}")
Этот подход позволяет агенту осмотреться. JavaScript выполняется на нашей стороне, поэтому вы получите контент даже с динамических страниц. Собственный браузер при этом запускать не придется.
Что не сработает
Поиск не заменит браузер полностью. Это не сработает - если агенту нужно нажать кнопку "Оплатить", пройти капчу или взаимодействовать с холстом Figma. Поисковый API в таких случаях отдаст только статический слепок страницы. Для активных действий Browserbase остается единственным решением. Разделение ответственности сохраняет стабильность системы.
Можно ли полностью отказаться от браузера в пользу срезAI?
Только при сборе и анализе информации. Для действий внутри аккаунтов или сложного UI-взаимодействия браузерный рантайм остается обязательным элементом.
Насколько срезAI дешевле браузерных сессий?
Запрос к API стоит 0,10 ₽. Сессия в облаке дороже в 15-20 раз.
Работает ли срезAI с динамическим контентом?
Да. Мы обрабатываем динамику на своей стороне, а вы забираете готовый Markdown из отрисованной страницы.
Как быстро интегрировать срезAI в существующий агент?
Используйте стандартный REST API или наш MCP-сервер. Достаточно добавить один узел в цепочку перед вызовом браузера.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.