TL;DR
- Веб меняется: поисковые рейтинги двигаются, страницы обновляются и удаляются. Один и тот же запрос сегодня и через месяц даёт разные наблюдения.
- При росте оценки на 5-8% невозможно отделить улучшение модели от изменения выдачи. Результат - невоспроизводимый бенчмарк.
- Решение - два слоя: live-поиск для реальных данных и snapshot/replay для контролируемых тестов версий пайплайна.
- Заморозка 100 тестовых запросов по Рунету через read_url стоит около 10₽ один раз. Перетестирование версий - бесплатно.
Методология: что именно мы измеряли
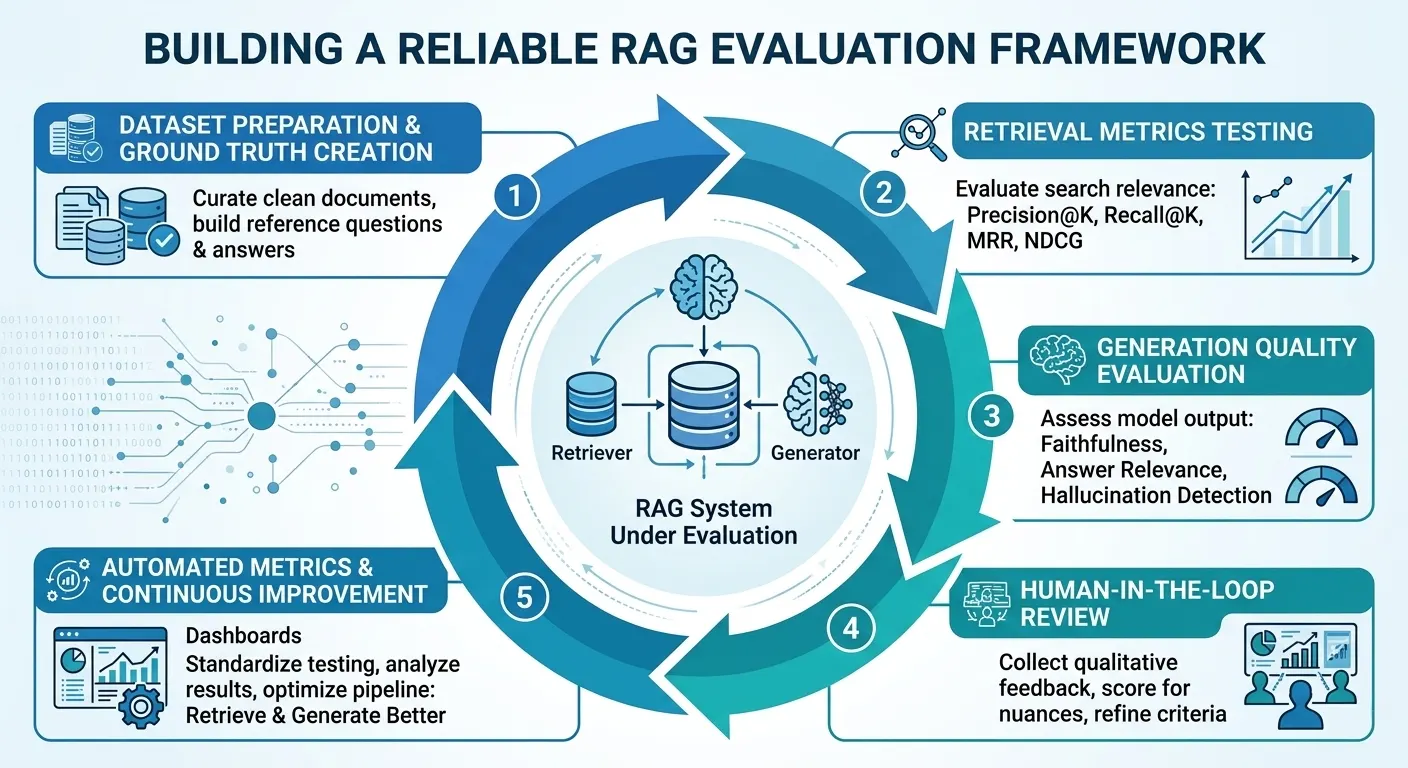
Взяли 100 запросов по российской фактуре: новости компаний, регуляторные документы, региональные события. Для каждого запроса один раз сохранили выдачу и содержимое топ-5 страниц в локальный снапшот. Далее прогнали два варианта пайплайна - v1 и v2 с другим промптом рерайтинга запросов - против замороженного снапшота, а затем против live-выдачи. Это дало четыре числа вместо двух и позволило увидеть дрейф.
| Режим эвалюации | v1, точность ответа | v2, точность ответа | Разница | Что на самом деле измеряется | |||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Snapshot (заморожено) | 71,0% | 77,0% | +6,0% | Качество промпта и модели | |||||||
| Live выдача, неделя 1 | 71,0% | 74,5% | +3,5% | Модель + состояние веба | Live выдача, неделя 4 | 72,5% | 76,0% | +3,5% | Модель + дрейф выдачи | Дрейф веба (v1, неделя 1 → 4) | 71,0% |
Ключевое наблюдение: одна и та же модель без любых изменений даёт +1,5 п.п. только за счёт того, что в выдаче появились свежие статьи. На коротких дистанциях дрейф маскирует реальный прогресс; на длинных - может его полностью перекрыть. Если дельта версии меньше величины дрейфа, бенчмарк бесполезен.
Архитектура двух слоёв
Слой live-поиска нужен, чтобы агент видел актуальное состояние мира - новые законы, свежие цены, текущие события. Слой snapshot/replay нужен, чтобы эксперименты были сравнимы. Это разные задачи, и попытка решить их одним инструментом приводит к невоспроизводимым метрикам. Для snapshot-слоя достаточно один раз сохранить запросы, сниппеты и полный текст ключевых страниц.
import json, hashlib, os, requests, datetime API = "https://api.srezai.ru/v1"
KEY = os.environ["SREZAI_API_KEY"]
HEADERS = {"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"} QUERIES = [ "ставка НДС для IT-услуг в России 2026", "требования 152-ФЗ к хранению персональных данных", "оборот розничной торговли в Москве за квартал",
] def search(q): r = requests.post(f"{API}/search", headers=HEADERS, json={"query": q, "num": 5}, timeout=60) r.raise_for_status() return r.json() def read(url): r = requests.post(f"{API}/read_url", headers=HEADERS, json={"url": url, "max_chars": 20000}, timeout=90) r.raise_for_status() return r.json() def freeze(): """Один раз сохраняет выдачу и тексты страниц — это и есть snapshot-слой.""" snapshot = {"created": datetime.date.today().isoformat(), "queries": []} for q in QUERIES: res = search(q) pages = [] for hit in res["results"][:5]: try: pages.append({"url": hit["url"], "title": hit["title"], "snippet": hit["snippet"], "content": read(hit["url"]).get("text", "")}) except requests.RequestException: pages.append({"url": hit["url"], "title": hit["title"], "snippet": hit["snippet"], "content": ""}) snapshot["queries"].append({"query": q, "results": pages}) h = hashlib.sha256(json.dumps(snapshot, ensure_ascii=False).encode()).hexdigest()[:12] path = f"snapshot_{h}.json" with open(path, "w", encoding="utf-8") as f: json.dump(snapshot, f, ensure_ascii=False, indent=2) print(f"snapshot: {path}") return path def replay(path, pipeline_fn): """Прогоняет любую версию пайплайна против замороженных данных.""" with open(path, encoding="utf-8") as f: snapshot = json.load(f) return [pipeline_fn(q["query"], q["results"]) for q in snapshot["queries"]] if __name__ == "__main__": freeze()Когда нужен каждый слой
- A/B-тесты промптов, рерайтинга и чанкинга - только snapshot. Любая live-добавка сделает числа несравнимыми.
- Проверка покрытия источников и свежести данных - только live. Здесь дрейф - это сигнал, а не помеха.
- Регрессия перед релизом - snapshot плюс небольшой live-прогон для контроля дрейфа.
- Сбор датасета для дообучения - live на сборе траекторий, snapshot для воспроизведения ошибок и отладки.
Выводы
Невоспроизводимый бенчмарк хуже, чем отсутствие бенчмарка: он даёт уверенность там, где её быть не должно. Если метрика версии выросла меньше, чем дрейф выдачи за период измерения, вы измеряете веб, а не свою модель. Заморозка тестового набора стоит один раз и недорого, а восстановлен сравнение версий на любой дистанции. Главная эвристика: любое утверждение про рост качества RAG должно сопровождаться описанием того, в каком состоянии были источники.
Как понять, что мой RAG-бенчмарк невоспроизводим?
Прогоните одну и ту же версию пайплайна на тех же запросах с разницей в 2-4 недели. Если разброс метрики превышает изменения между версиями, бенчмарк измеряет дрейф выдачи, а не модель.
Насколько большим бывает дрейф поисковой выдачи?
В нашем тесте на 100 запросах по Рунету дрейф составил +1,5 п.п. за 3 недели без изменений в пайплайне. На новостных и региональных запросах он выше, на энциклопедических - ниже.
Нужно ли замораживать содержимое страниц, а не только ссылки?
Да. Страницы обновляются и удаляются. Для воспроизводимости нужен полный текст: заморозка через read_url сохраняет отрисованный контент, а не только URL.
Как часто пересобирать snapshot?
Раз в 1-3 месяца, в зависимости от тематики. Быстро меняющиеся домены требуют более частого пересбора, и каждый новый снапшот стоит сравнивать с предыдущим, чтобы оценивать дрейф.
Подойдёт ли этот подход для эвалуации глубоких research-агентов?
Да, но дополнительно стоит сохранять траекторию: сам запрос, выбор источников, решение о продолжении поиска. Заморозить нужно не только данные, но и шаги, иначе вы не воспроизведёте путь агента.
Что дешевле: пересобирать снапшот или прогонять live-тесты?
Пересборка дешевле: 100 запросов × 5 страниц стоят около 10₽ при цене 0,10₽ за запрос, а платит за неё команда один раз. Live-прогоны повторяются при каждом тесте.
Заморозьте свой тестовый набор за 10₽
Получить 1000 кредитовСвой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.