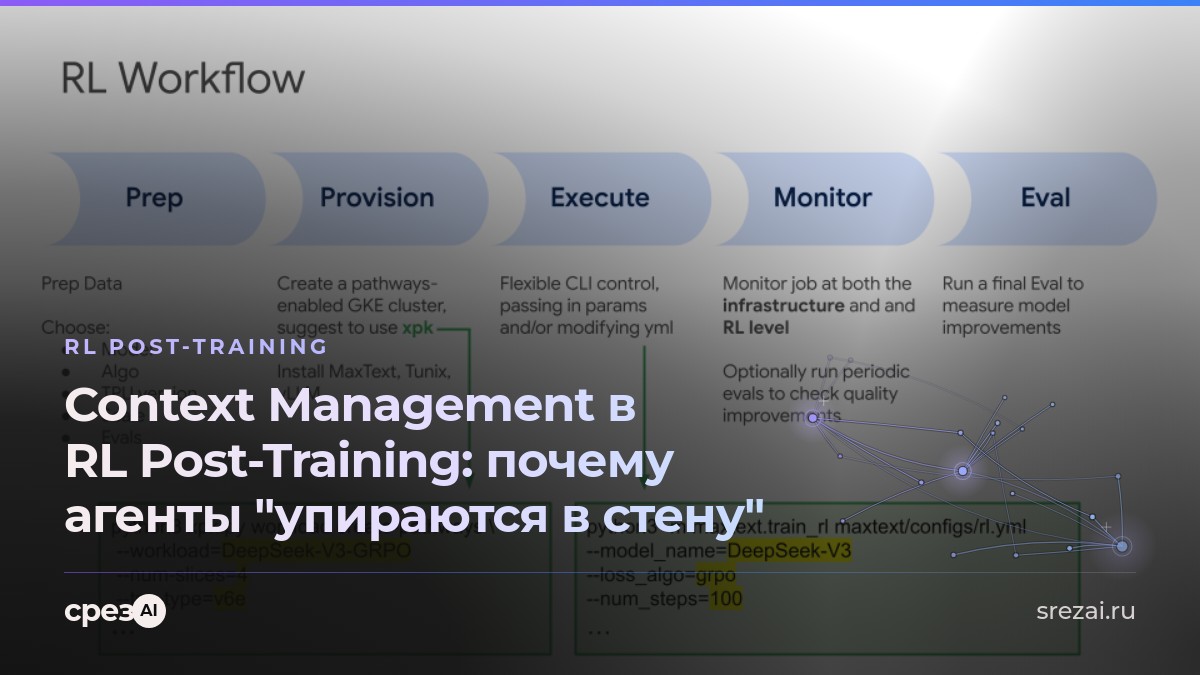
При RL-обучении модель делает сотни попыток, формируя траектории из размышлений, вызовов инструментов и ответов API. В задачах поиска один цикл из 5 ходов раздувает контекст до 335 000 токенов. При этом 96% объема - это сырой мусор из файлов и веб-страниц. Когда лимит исчерпан, модель теряет нить рассуждений, игнорирует ранние факты и выдает галлюцинации.
Что эффективнее: скользящее окно или суммаризация
Исследование в блоге Tavily на модели Qwen3-4B показало результаты трех подходов для задач GSM8K и HotpotQA. Обычная суммаризация через внешнюю LLM часто вносит шум и искажает логику агента. Стратегия sliding-window просто оставляет N последних ходов. Она показала высокую точность и тратит меньше токенов.
| Стратегия | Эффективность (Qwen3-4B) | Расход токенов | Риски |
|---|---|---|---|
| Append-only (все сразу) | Низкая (лимит 128K) | Критический | Остановка на середине задачи |
| LLM Summarization | Средняя | Высокий | Искажение фактов при пересказе |
| Sliding-window | Высокая | Оптимальный | Потеря старых данных |
Разработчику выгоднее настроить фильтрацию на входе, чем строить сложные схемы пересказа истории. В этом помогает инструментарий срезAI. Вместо загрузки страницы целиком, инструмент extract вытягивает нужные поля, а read_url отдает чистый Markdown. Это замедляет заполнение окна. Агент доходит до финала траектории, сохраняя память обо всех важных этапах.
Экономьте токены при обучении агентов: чистый Markdown и семантическая фильтрация в один клик.
Попробовать срезAI бесплатноКак реализовать эффективный токен-менеджмент
Главное - не пускать мусор в контекст. Мы используем headless-браузер, который обрабатывает динамический контент и возвращает только значимый текст. Этот код на Python можно вставить в цикл обучения для получения компактных данных.
import os
import requests def get_lean_context(url): # JavaScript выполняется на стороне срезAI, мы получаем только текст response = requests.post( "https://srezai.ru/api/read_url", headers={"Authorization": f"Bearer {os.environ['SREZAI_API_KEY']}"}, json={"url": url, "maxChars": 4000} ) return response.json().get("text", "")
Даже качественный поиск не спасает, если сессия слишком длинная. Предварительная очистка контента лишь откладывает проблему. Это не сработает, если задача требует больше 20 ходов - в таких случаях sliding-window приходится комбинировать с периодической суммаризацией планов.
Почему sliding-window лучше суммаризации в RL?
Суммаризация теряет технические детали: аргументы функций и пути к файлам. Окно хранит оригиналы.
Какой объем контекста оптимален для поискового агента?
Для Qwen3 или Llama 3 подходит окно в 128 000 токенов. Учитывайте, что полезная информация должна занимать около 15-20% от этого лимита, иначе модель начнет путаться в данных.
Как срезAI помогает экономить бюджет на обучение?
Данные приходят в чистом Markdown без HTML-тегов, что снижает вес одного результата поиска в 5-10 раз.
Работает ли этот подход для медицинских или юридических агентов?
Подход универсален, но фильтрация через extract требует строгих настроек, чтобы сохранить юридические оговорки.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.