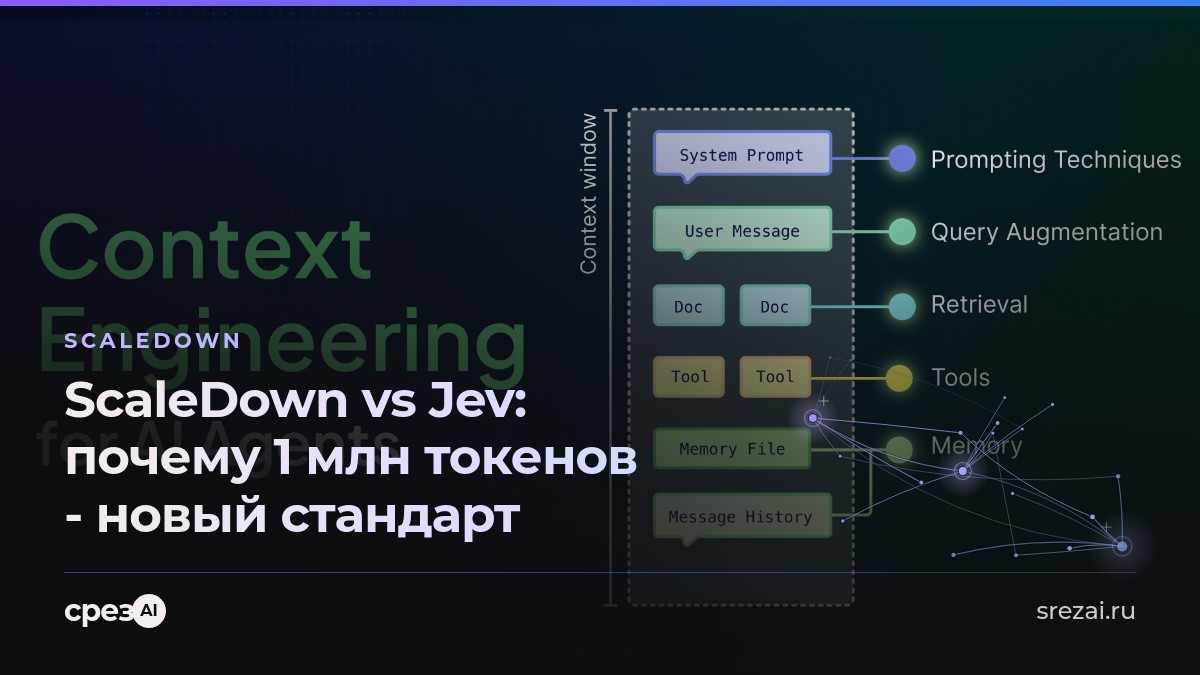
ScaleDown - это семейство узкоспециализированных моделей (Summarize, Compress, Extract, Classify), построенных на архитектуре Constrained Decoding Models (CDM). В отличие от универсальных систем вроде Jev, они заточены под конкретные операции и работают как фильтры перед подачей данных в основную LLM. На практике это выглядит так: вы скармливаете модели гигантский массив документов, а она выжимает из них суть, не пропуская детали из-за нехватки памяти.
Сравнение характеристик
| Параметр | ScaleDown (CDM) | Jev |
|---|---|---|
| Контекстное окно | 1 000 000 токенов | 32 000 токенов |
| Скорость обработки | ~200x быстрее frontier-LLM | Стандартная |
| Мультимодальность | PDF, изображения, текст | Только текст |
| Стоимость | в 467 раз дешевле GPT-4o | Рыночная |
Как это работает в связке со срезAI
При поиске через API срезAI агент часто получает десятки страниц текста. Если передавать их в модель напрямую, контекст переполняется. Модель ScaleDown Compress сжимает результаты до чистого Markdown. Мы сами выполняем JavaScript, поэтому CDM получает отрисованный контент, готовый к моментальной суммаризации. Мне пришлось потратить время на настройку промптов для Compress, так как модель иногда слишком агрессивно вырезает технические подробности.
import os
from langchain_community.tools.srezai import SrezaiWebSearch # Получаем 10 страниц через срезAI
search = SrezaiWebSearch(api_key=os.environ["SREZAI_API_KEY"])
results = search.run("последние бенчмарки ScaleDown октябрь 2026") # Сжимаем контекст через ScaleDown CDM перед финальным ответом
# Это позволяет уместить 1 млн токенов поиска в 2-4к полезного вывода
Попробуйте интеграцию срезAI с моделями CDM для работы с большими данными.
Начать поискОграничения и нюансы
ScaleDown не заменит GPT или Claude для рассуждений. Это "умный пылесос": он собирает и упаковывает данные, но плохо справляется с креативным письмом или логикой. Это не сработает - если вы попытаетесь написать через CDM сложный код или художественный текст. При работе с PDF объемом более 500 страниц иногда проявляется эффект "потерянной середины", когда точность экстракции в центре документа падает.
Можно ли использовать ScaleDown CDM для общения с пользователем?
Инструмент создан для технической обработки данных внутри пайплайна, а не для диалогов. В чате лучше оставить стандартную LLM, скормив ей уже подготовленную выжимку.
Поддерживает ли срезAI работу с этими моделями?
Поддержка реализована через LangChain-интеграцию.
В чем преимущество CDM перед обычным RAG?
CDM видит весь объем данных сразу без дробления на куски, поэтому не теряет смысловые связи между главами или разделами документа.
Сколько стоит один запрос к ScaleDown?
По актуальным данным на октябрь 2026 года, выполнение задачи через CDM открывает страницы в 400 с лишним раз дешевле frontier-моделей.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.