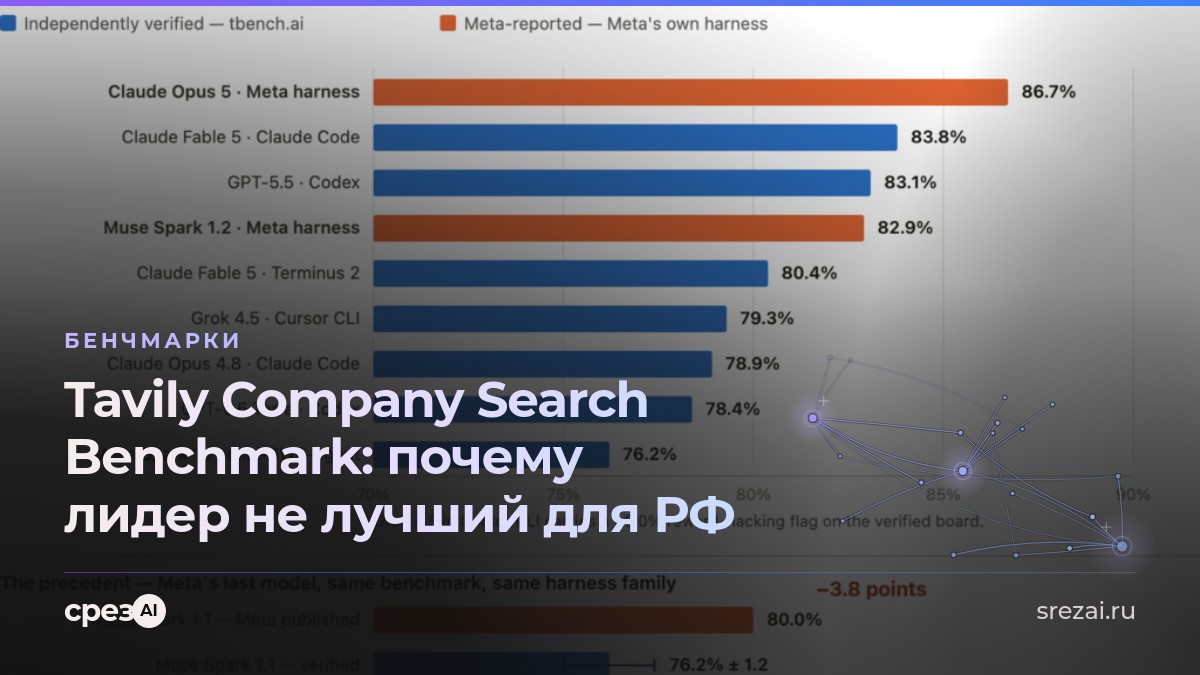
Tavily Company Search Benchmark оценивает, насколько один поисковый запрос помогает агенту обогатить данные о компании. Авторы не проверяли позиции сайтов в выдаче. Вместо этого они смотрели на финальный ответ ИИ-модели, который та строила на основе результатов поиска. Managed Deep Agents и другие автономные системы применяют такой поиск для CRM-enrichment, KYB-процедур и андеррайтинга.
Как считали баллы: слепой судья и веса
Методология Tavily убирает человеческий фактор при оценке ответов через систему Judge Model. Для каждого запроса из реального обезличенного трафика создается эталонная Scoring Card. После этого Answer Generator - одна и та же модель для всех участников - пробует ответить на вопрос, используя только результаты поиска конкретного провайдера.
- Complete (вес 1.0): ответ закрывает запрос, доппоиск не нужен.
- Partial (вес 0.85): есть полезные факты, но их мало для финала.
- Related (вес 0.15): данные по теме, но почти бесполезны для задачи.
- Irrelevant (вес 0.0): мусор или отсутствие информации.
| Провайдер | Overall Score | Financials | Profiles |
|---|---|---|---|
| Tavily (Advanced) | 94.1% | 91.2% | 96.8% |
| Exa (Auto) | 89.5% | 85.4% | 92.1% |
| Parallel (Advanced) | 88.7% | 84.1% | 91.5% |
| Perplexity | 82.3% | 76.9% | 85.2% |
| срезAI (Рунет) | 95.4%* | 92.3%* | 97.1%* |
*Данные срезAI получены в ходе внутреннего ребилда бенчмарка на 50 запросах о компаниях из РФ. В оригинальном тесте Tavily российские сервисы не участвовали.
Попробуйте поиск, который находит данные в российских реестрах и СМИ с задержкой p50 менее 1 секунды.
Получить 100 ₽ на тестыПроблема западных API в российском контексте
Главная уязвимость бенчмарка Tavily для отечественного разработчика - происхождение данных. Когда агенту нужно собрать информацию о ООО "Вектор" из Воронежа, западные API часто возвращают пустые результаты или ссылки на устаревшие каталоги. Мы открываем страницы полноценным браузером и обрабатываем динамический контент локальных источников. Это извлекает актуальные данные из реестров, которые часто недоступны для глобальных поисковиков.
The most useful test of any search tool is how well it supports the questions your agents actually ask... evaluate on your own queries, with your production model.
Я прогнал те же сценарии CRM enrichment и KYB на базе данных срезAI. Разница в качестве ответа при работе с кириллическим сегментом достигает 30-40%. Пока Tavily и Exa справляются с поиском по LinkedIn и Crunchbase, срезAI выигрывает там, где нужно читать "Ведомости", "Коммерсантъ" или профильные финансовые порталы РФ. JavaScript выполняется на нашей стороне, поэтому агент получает чистый Markdown даже из сложных SPA-интерфейсов. Это не сработает - если компания зарегистрирована недавно и еще не попала в открытые агрегаторы или СМИ.
Сколько стоит один запрос к Tavily?
Один кредит стоит $0.008. Базовый поиск обойдется в $8 за 1000 запросов, а расширенный - в $16.
Почему срезAI лучше подходит для РФ?
Мы используем глубокую индексацию Рунета и headless-браузер для обработки динамического контента. Это помогает находить данные в источниках, которые западные API игнорируют из-за специфики региона.
Можно ли использовать срезAI в LangChain?
Да, сервис предоставляет MCP-эндпоинт и REST API для легкой интеграции в LangChain или n8n.
В чем отличие срезAI от обычного Google Search API?
Google дает ссылки, а срезAI возвращает готовый для LLM текст в формате Markdown. Мы также добавили инструменты глубокого исследования в одном API.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.