Встроенные инструменты поиска от Anthropic часто скрывают детали реализации. Когда Claude ищет информацию сам, разработчик получает готовый ответ, но теряет контроль над источниками и форматом данных. Managed Deep Agents - это подход, при котором поиск выносится в отдельный управляемый слой. Его можно отлаживать и фильтровать.
#Результаты бенчмарка SealQA-Hard
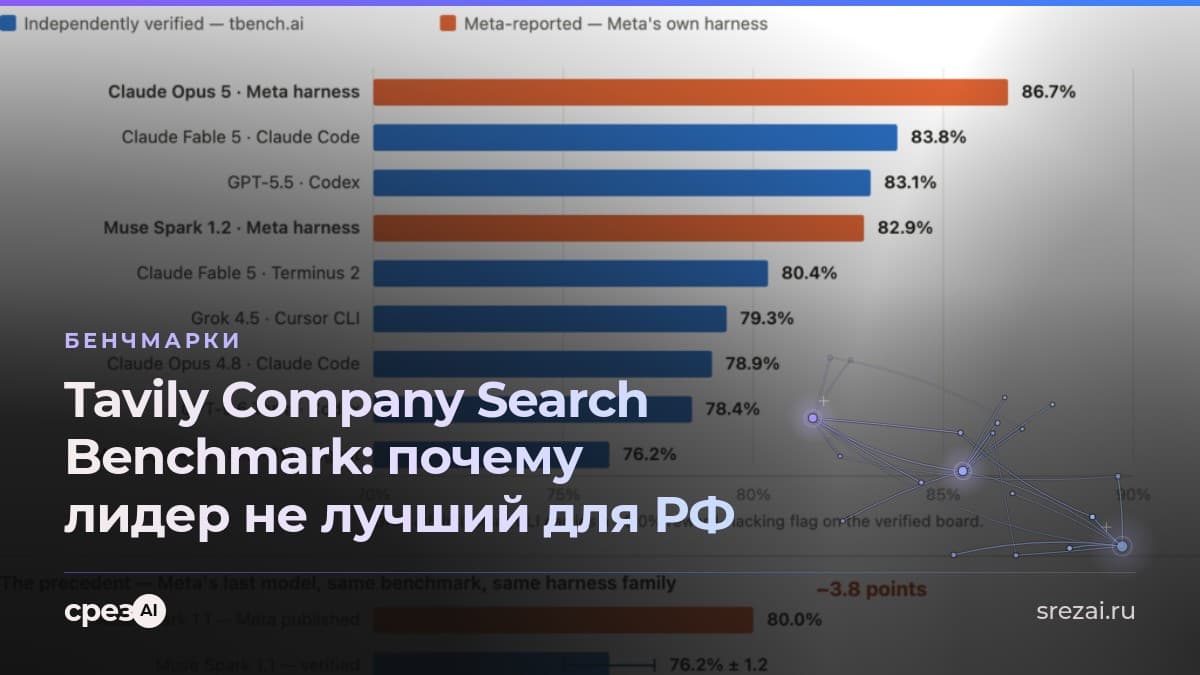
В тесте на 254 сложных вопроса, требующих синтеза данных из разных источников, Tavily обошел стандартный поиск Anthropic. Ключевым фактором стала релевантность выдаваемого контента. Это не сработает - если ваш сценарий не требует глубокого сканирования страниц, так как базовый поиск Claude справляется с простыми фактами быстрее.
Я пробовал подключать оба варианта. Claude Native подкупает скоростью настройки, но быстро сжигает бюджет на длинных статьях. С Tavily пришлось повозиться, настраивая фильтры доменов, зато мусор в контекст больше не залетает.
| Метрика | Claude Native | Tavily Basic | Tavily Advanced |
|---|---|---|---|
| Точность (SealQA-Hard) | Базовая | Аналогично | +15.3% |
| Расход токенов | 100% | ~60% | ~85% |
Разделение поиска и рассуждений модели позволяет чистить контекст еще до того, как он попадет в дорогое окно контекста LLM.
Почему Tavily экономит токены?
Сервис очищает HTML-код от навигации, рекламы и лишних скриптов, отдавая модели только чистый текст. Это сокращает объем данных на 40%.
Можно ли использовать оба инструмента вместе?
Технически ограничений нет, но это создаст избыточность и увеличит задержку ответа.
Свой веб-доступ для агента: поиск, чтение страниц и извлечение данных по одному ключу.